Ищу работу: CTO, Engineering Manager, Tech Lead
Ещё раз.
Недавно я закончил творческий отпуск — пришло время искать работу.
Если вам нужен лидер технического направления, который может и мешки ворочать, и руками махать, — пишите, с радостью пообщаюсь. Если вы организуете стартап, тоже пишите.
Фронт работ и уровень влияния на результат для меня важнее названия роли. Если у вас есть задача или проблема без понятного решения (в команде, процессах, коде) — рассказывайте. Я разберусь в сути дела, вместе с вами сформулируем видение конечного результата и наметим путь его достижения. Если нужно, обучим / вырастим / наймём команду. А как роль назвать, разберёмся в процессе.
Много деталей моего увлекательного 20-летнего пути в разработке (и 13-летнего в геймдеве) можно найти в этом блоге. Например, вот серия постов о моих взглядах на менеджмент и годовые отчёты.
Важное обо мне, помимо указанного в CV:
- Разработка ПО — не только моя работа, но и хобби. Благодаря этому мой кругозор немного шире, а опыт разнообразнее.
- Смотрю на продукт как на эмерджентную систему из людей, «машин» и процессов — учитываю их влияние друг на друга.
- Я за самоорганизацию, автономность и прозрачность работы людей и команд.
- Не навязываю то, что сам не готов делать, — всегда стараюсь подавать личный пример.
- Делаю то, что нужно делать; делегирую то, что можно делегировать.
Что ищу:
- Продуктовая компания малого или среднего размера. Пусть будет до 200 человек.
- Полная удалёнка.
- Часовые пояса Европы, плюс-минус.
- Equity / опционы / процент от прибыли с чёткими критериями получения.
Если вы занимаетесь чем-то из нижеперечисленного, нам будет легче договориться:
- Deep tech, R&D.
- Нетривиальное использование LLM, агентов и прочего ИИ.
- Инди или экспериментальный геймдев, инструменты для геймдева.
- Процедурная генерация в широком смысле, включая генерацию историй, виртуальных инфлуенсеров, etc.
- Rust, включая Rust для web.
Не рассматриваю:
- Работу в офисе.
- Аутсорс, аутстафф.
- Компании, любым способом действующие в подсанкционных странах.
- Продукты в серой этической зоне: крипту, азартные игры, сервисы знакомств, etc.
Если я вам интересен, напишите пару слов о продукте, команде и задаче, которую хотите решить с моей помощью:
- Telegram: t.me/Tiendil
- LinkedIn: linkedin.com/in/tiendil
- Email:
a.eletsky@gmail.com
Дашборд активности игроков Monsters & Memories
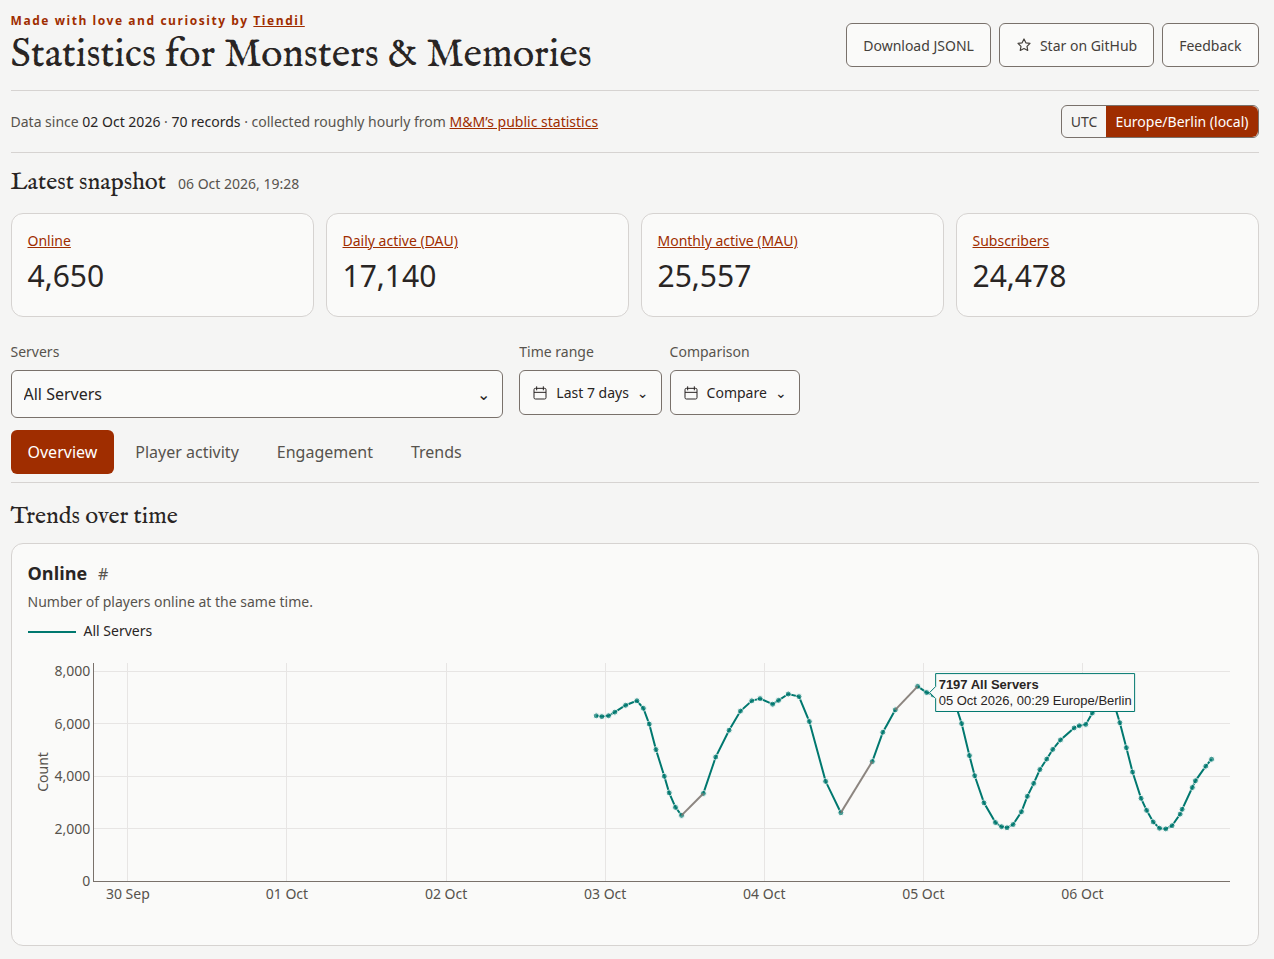
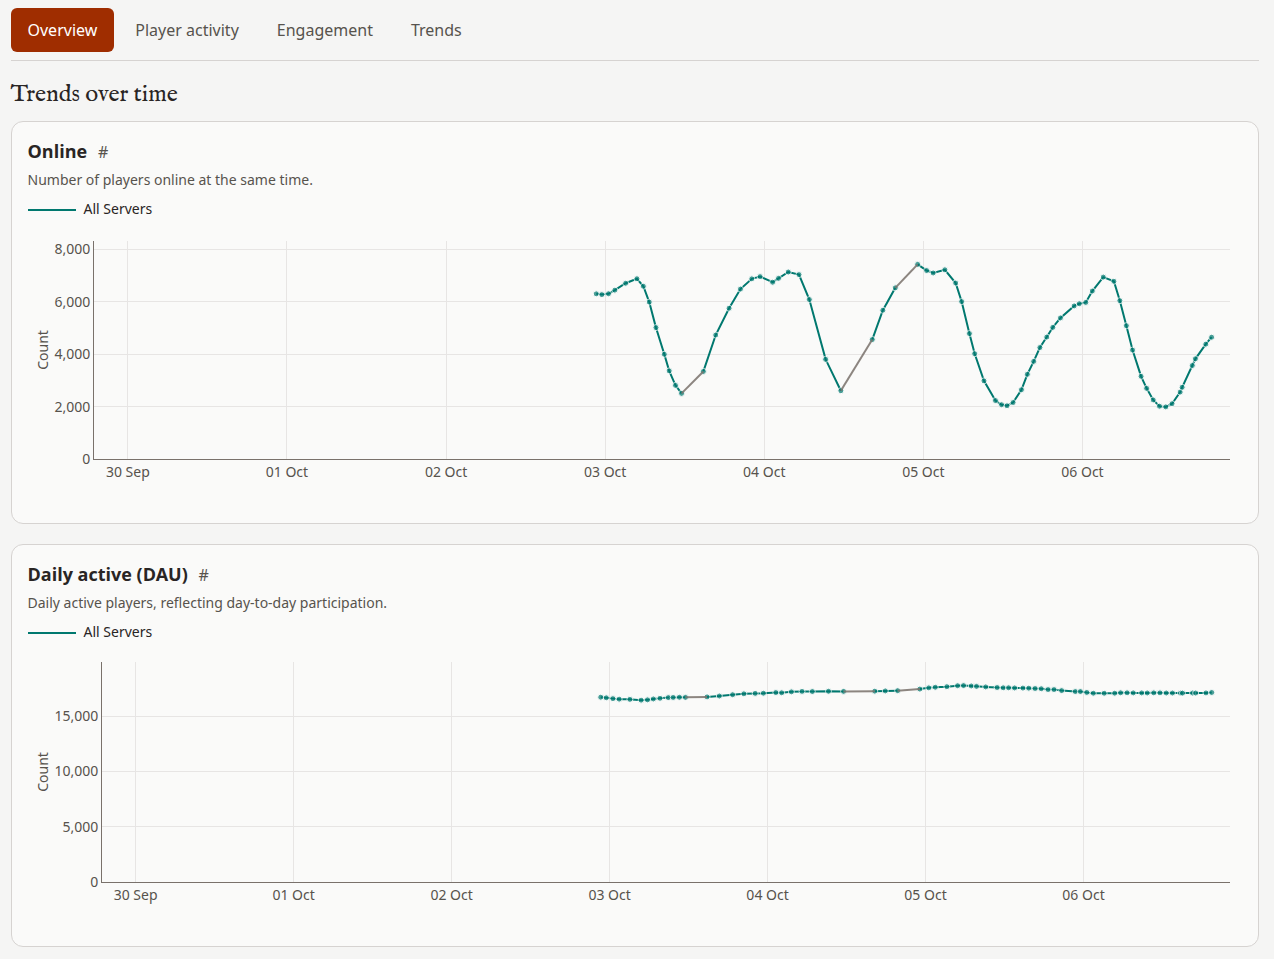
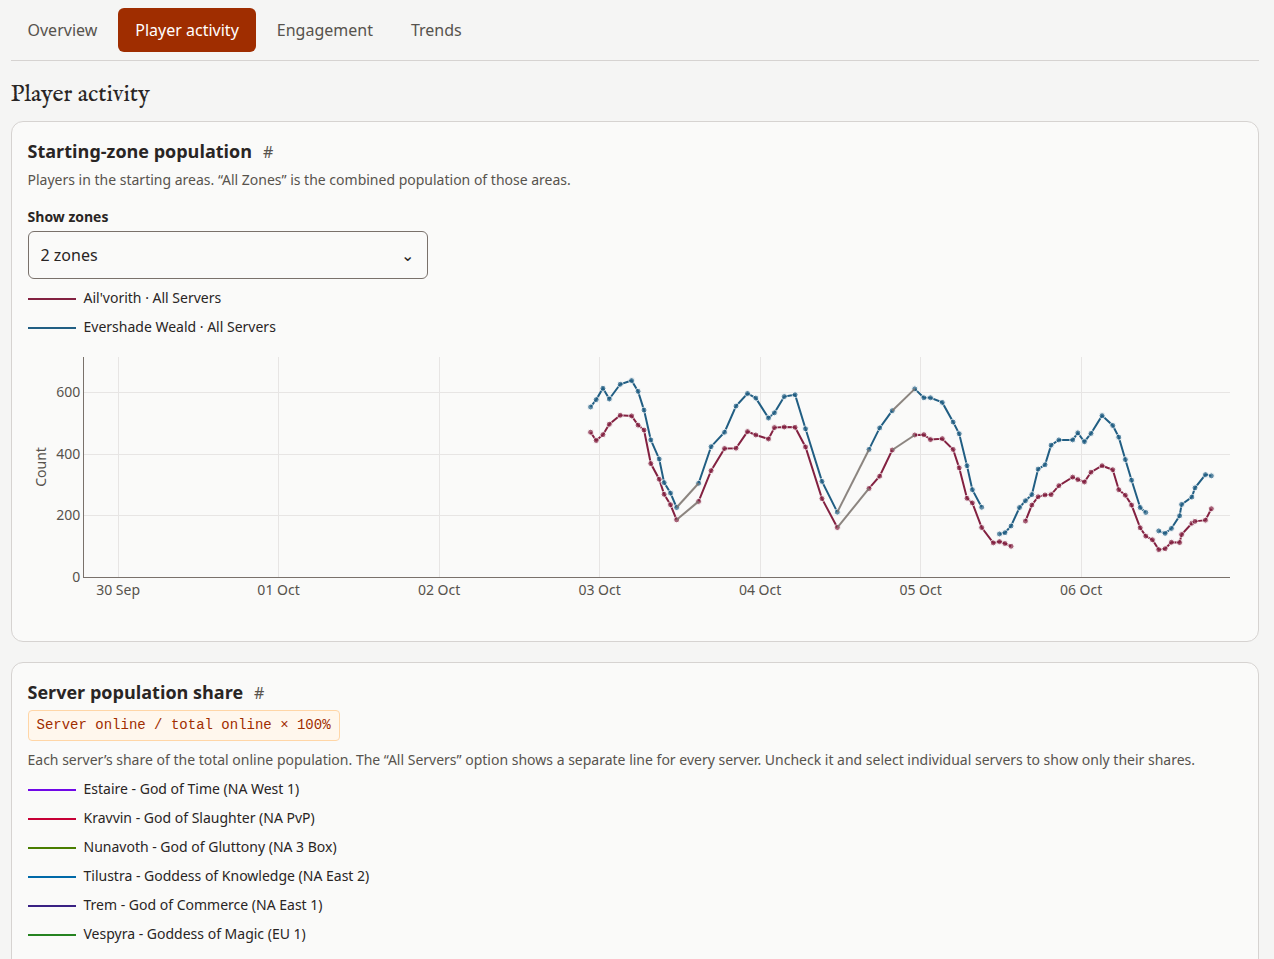
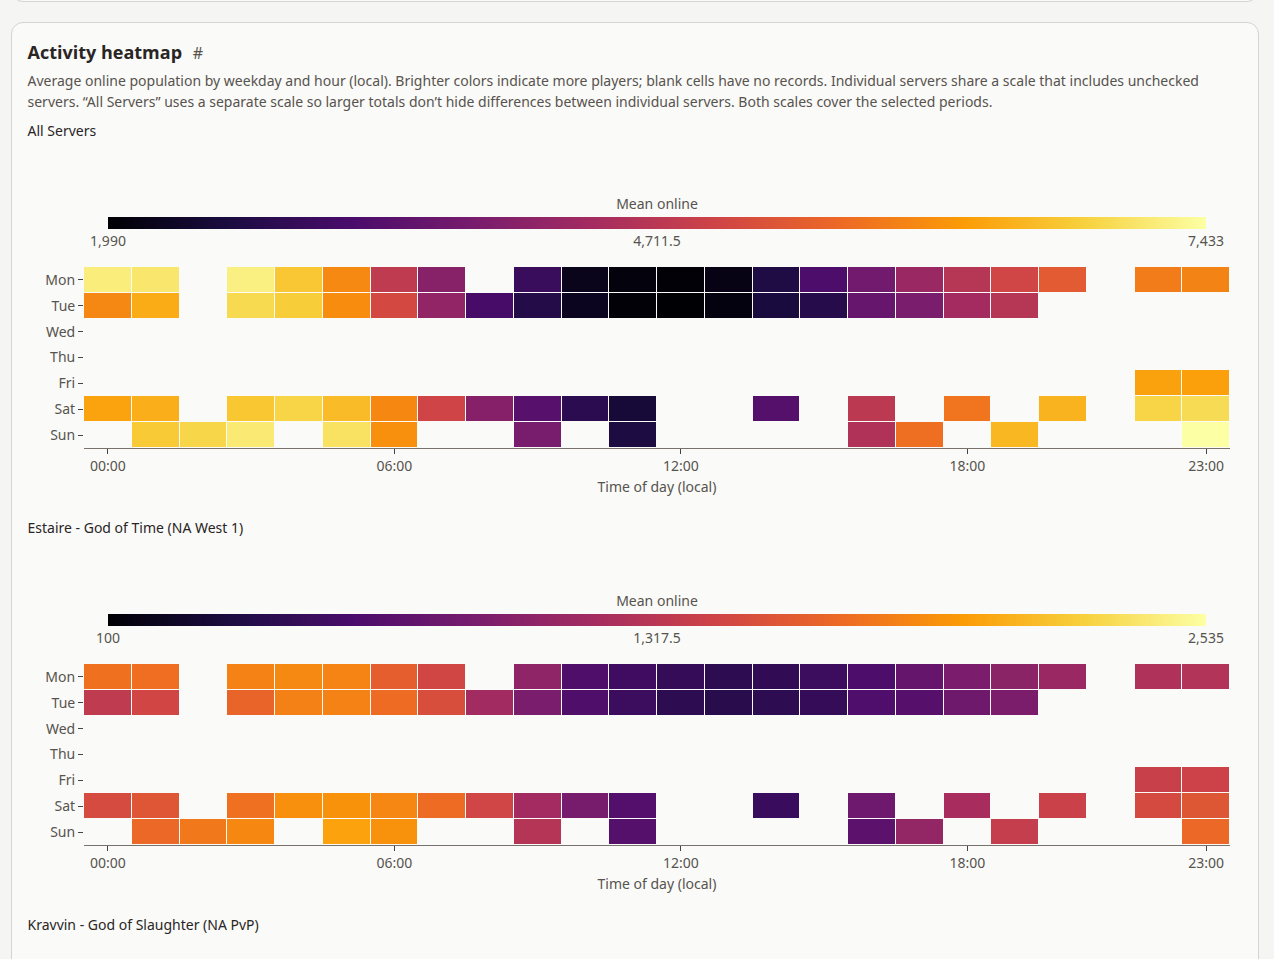
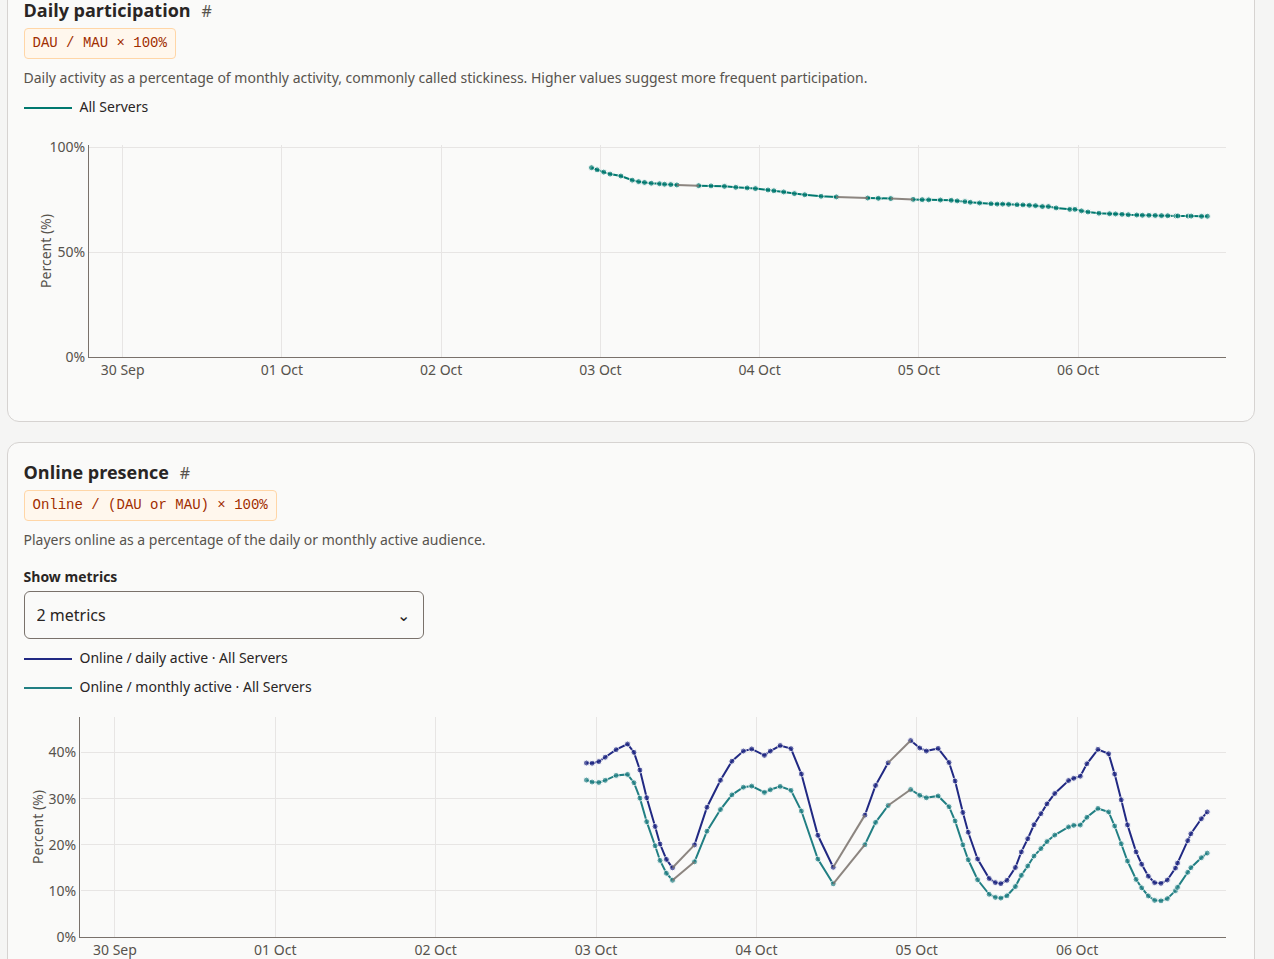
Разработчики Monsters & Memories открыли часть метрик игры, включая количество подписчиков. Это редкость в индустрии и заслуживает всяческого уважения. К сожалению, на официальной странице статистики доступны только актуальные метрики, без истории. Чтобы исправить это, я начал делать почасовые снимки метрик. Одно за другим и за 4 дня я навайбкодил целый дашборд.
Дашборд: tiendil.github.io/monsters-and-memories-stats
Репозиторий: github.com/Tiendil/monsters-and-memories-stats
Что на нём можно найти:
- Обзор: онлайн, DAU, MAU и подписчики.
- Активность игроков: онлайн на серверах, онлайн в стартовых зонах, тепловые карты активности игроков по дням недели и часам.
- Вовлечённость: как онлайн, DAU, MAU и подписки соотносятся друг с другом.
- Тренды: рост серверов, часы пик и активность в стартовых локациях (будет доступно после нескольких недель сбора данных).
Поскольку игра недавно вышла в ранний доступ, истории пока мало, но я надеюсь, что со временем дашборд станет ценным ресурсом для игроков и разработчиков игр.
P.S. Разрабам M&M огромный респект — кто из нас не мечтает сделать своё MMO с эльфками и монетизацией? — реальные цифры будут к месту для «заземления».
Итоги творческого отпуска 2024-2026 годов
Идиоматически проводим творческий отпуск.
В 2023 году Юля сделала таблицу из 1000 лаб (!), выбрала из них одну, переехала в Германию и начала делать PhD в ней. Мы год полетали друг к другу между Польшей и Германией, поняли, что это жуть как неудобно и дорого, поэтому я уволился из Palta и в начале 2024 года переехал прицепом жены в Германию.
«Отличный повод уйти в очередной творческий отпуск», — подумал я, после чего так и сделал. Два с половиной года спустя пришло время искать работу подводить итоги.
В этом посте вы найдёте полный отчёт о проделанном отдыхе: что было запланировано, как изменились планы, что удалось сделать, а что нет.
Краткие итоги: блог обновлён, 68 постов написано, 20 книг прочитано, 4 новых open source проекта реализовано, больше 400 звёзд на GitHub заработано, feeds.fun стал удобным в использовании и готов к монетизации, собственный подход к менеджменту сформулирован, странные, но интересные курсы разработки интеллектуальной собственности пройдены, с ИИ разобрался, coding agents кодят, глаз у жены дёргается.
Ссылки для лучшего понимания поста:
- Что такое творческие отпуска и почему я в них хожу.
- Это мой второй полноценный саббатикал, вот отчёт по первому.
DepMesh — делаем зависимости между файлами частью архитектуры проекта
Перед внесением изменений, например в код, агенты часто должны ответить на прикладные вопросы:
- Какие тесты следует прочитать перед изменением этого файла?
- Какие спецификации регулируют этот модуль?
- Какие модули импортирует этот код?
- Какие артефакты затронуты этим изменением спецификации?
- etc.
Иными словами, агент должен обнаружить все зависимости между файлами и добавить их в контекст, чтобы корректно выполнить задачу.
Получение ответов на подобные вопросы требует от агента подумать, сформировать план действий, выполнить его и проанализировать результаты. Всё это съедает токены, контекст и время, без гарантии полноты и корректности результата.
Например, агент должен решить каким способом искать каждый конкретный тип зависимостей. Иногда, как в случае с цепочками импортов, агент должен прочитать и распарсить исходник, чтобы понять какие модули он импортирует, а затем сгенерировать пути к этим модулям и прочитать их — трудоёмко и неэффективно.
Результат такого «агентного поиска» не гарантирован, агент может забыть погрепать по имени функции и потерять важную зависимость, или пропустить нишевую спеку, потому что решил, что именно в данном случае она не нужна.
Более того, для поиска агент задействует кучу инструментов, каждый из которых самим своим использованием увеличивает потребление токенов и отъедает контекст. Для одной и той же задачи агент может раз от раза выбирать разные инструменты или вызывать их с разными параметрами, что убивает предсказуемость и воспроизводимость результата.
Общепринятые способы улучшить ситуацию, это интеграция LSP или чего-то подобного в качестве инструмента агента или разворачивание одной из миллиона RAG-систем. Это помогает делу, но не снимает все проблемы. Например, не гарантирует полноту, минимальность и детерминированность результата.
В то же время, с древних времён у нас есть огромный пул утилит и библиотек для поиска файлов и анализа исходного кода, которые умеют делать это быстро и эффективно, без всяких там LLM. Каждая из них в своей конкретной области работает намного лучше вероятностной модели.
Было бы здорово, подумал я, иметь одну абстракцию над всеми этими инструментами, которая предоставляет агенту универсальный интерфейс для извлечения любых зависимостей между файлами (какие настроите) и не требует от него думать что и каким образом искать.
Чтобы её можно было использовать, например, вот так:
> depmesh dependencies -r governed_by -r tested_by ./depmesh/cli/application.py

## governed_by

Specifications that apply to the artifact.

- @/specs/architecture/entities.md
- @/specs/architecture/errors.md
- @/specs/architecture/modules_layout.md
- @/specs/architecture/naming.md
- @/specs/architecture/static_analysis.md
- @/specs/architecture/tests.md
- @/specs/behavior/cli.md
- @/specs/behavior/file_paths.md

## tested_by

Tests that verify the artifact.

- @/depmesh/cli/tests/test_application.py
Так и появился DepMesh.
Donna готова к использованию
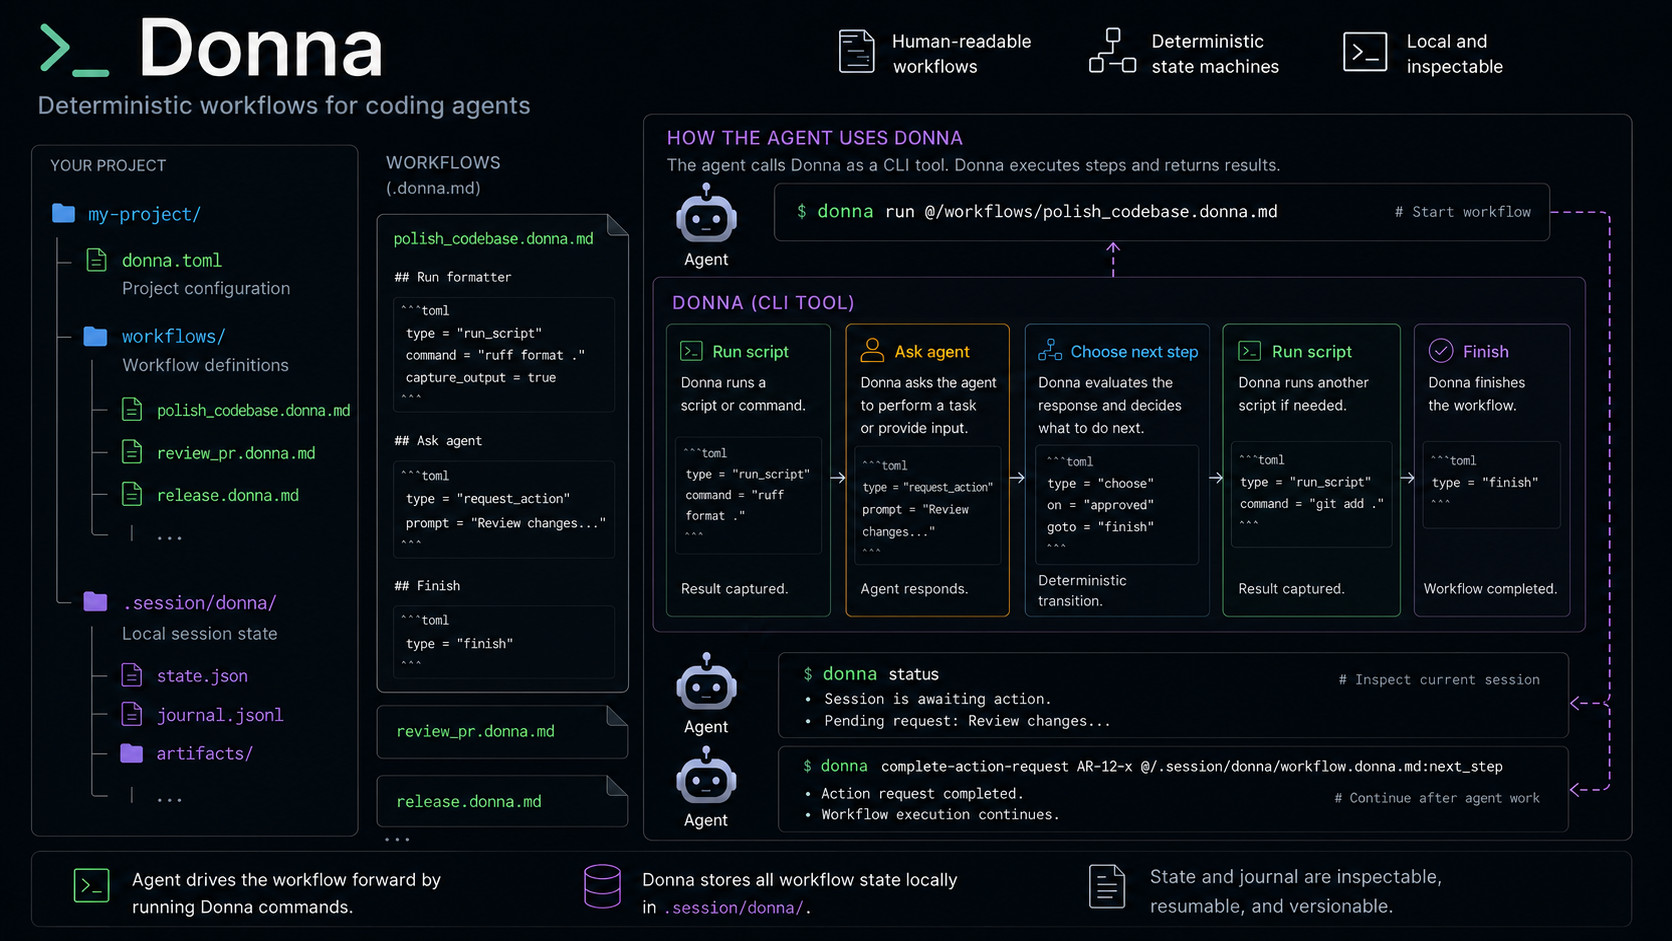
Как работает Donna.
В феврале я выпустил Donna(оригинальный пост) — CLI-утилиту для запуска агентных сценариев как стейт-машин и их описания в Markdown-файлах.
Поскольку я разрабатывал её одновременно разбираясь как работать с агентами, у меня получился переусложнённый, универсальный монстр. Donna имела много полезных функций, но совместно они слишком сильно ограничивали окружение разработчика и требовали слишком много времени на изучение.
Поэтому, набравшись опыта, я решил следовать философии Unix и отрефакторить монолит в набор меньших инструментов, каждый с отдельной чёткой зоной ответственности. Новая Donna — это первый из них (второй — это depmesh — я расскажу о нём в отдельном посте).
Новая Donna решает проблемы управления потоком исполнения агентов при длительной работе. Логика следующая:
- Большая часть разработки на мета-уровне повторяема: «запусти этот инструмент, что-то сделай с его выводом, запусти другой инструмент» или «реализуй функцию A, реализуй тесты для функции A, реализуй функцию B, …».
- Одни части этой работы требуют сложных рассуждений, другие — нет.
- Агенты
почтихороши в рассуждениях, но плохо держат в голове весь процесс: что уже сделали, что нужно сделать, в каком порядке, etc. - Поэтому логично отделить рассуждение от контроля потока исполнения — пусть агенты сосредоточатся на том, в чём они хороши, а поток можно отдать традиционным инструментам автоматизации.
Donna исполняет сценарии как детерминированные конечные автоматы, поэтому агент может сосредоточиться на рассуждении, генерации кода и другой агентной работе.